


VINCENZO, SCENDI IN CAMPO! - DE LUCA E' STUZZICATO ALL'IDEA DI CANDIDARSI ALLA PRIMARIE DEL "CAMPO…


IL PROBLEMA DELL’INTELLIGENZA ARTIFICIALE È CHE CI SOMIGLIA TROPPO: È INSICURA ED È STATA COSTRUITA PER COMPIACERE – QUANDO SI PROVA A CHIEDERE AI BOT “SEI SICURO?” QUELLI CAMBIANO SEMPRE IDEA E METTONO IN DISCUSSIONE LE LORO SCELTE – SI CHIAMA “SYCOPHANCY”, LA COMPIACENZA SERVILE ED È UN DIFETTO CHE NASCE IN FASE DI ADDESTRAMENTO: VALUTATORI UMANI HANNO INSEGNATO ALL’AI A PREFERIRE LE RISPOSTE ACCOMODANTI, RISPETTO A QUELLE ACCURATE. IL MODELLO IMPARA A DIRE CIÒ CHE IL SUO INTERLOCUTORE VUOLE SENTIRSI DIRE, NON CIÒ CHE È PIÙ GIUSTO. E LA SITUAZIONE PEGGIORA NEL TEMPO. LA SOLUZIONE? INSEGNARGLI A METTERSI IN DISCUSSIONE…
Traduzione da https://www.randalolson.com/
 la sycophancy, la compiacenza servile dell intelligenza artificiale.
Prova questo esperimento. Apri ChatGPT, Claude o Gemini e fai una domanda complessa. Qualcosa con vera sfumatura, come se dovresti accettare una nuova offerta di lavoro o restare dove sei, oppure se valga la pena rifinanziare il mutuo in questo momento. Riceverai una risposta sicura di sé, ben argomentata.
Ora digita: «Sei sicuro?»
Guarda cosa succede. Tornerà sui suoi passi, userà cautele, offrirà una nuova versione che contraddice parzialmente o totalmente ciò che aveva appena detto. Chiedi di nuovo «sei sicuro?». Tornerà indietro ancora. Al terzo giro, la maggior parte dei modelli comincia ad ammettere che li stai mettendo alla prova, il che è in qualche modo ancora peggio. Sanno cosa sta succedendo e comunque non riescono a mantenere la posizione.
Non è un bug curioso. È un problema strutturale di affidabilità che rende l’AI pericolosa nelle decisioni strategiche.
“Sycophancy” dell’AI: il segreto di Pulcinella dell’industria
I ricercatori chiamano questo comportamento “sycophancy” (compiacenza servile), ed è una delle modalità di fallimento più documentate nell’AI moderna. Anthropic ha pubblicato lavori fondamentali sul problema nel 2023, mostrando che i modelli addestrati con feedback umano tendono sistematicamente a preferire risposte accomodanti rispetto a quelle veritiere. Da allora, le prove non hanno fatto che rafforzarsi.
 la sycophancy, la compiacenza servile dell intelligenza artificiale.
Uno studio del 2025 di Fanous et al. ha testato GPT-4o, Claude Sonnet e Gemini 1.5 Pro in ambiti matematici e medici. Il risultato: questi sistemi hanno cambiato risposta quasi il 60% delle volte quando messi in discussione dagli utenti. Non si tratta di casi limite. È il comportamento predefinito, misurato sistematicamente, nei modelli che milioni di persone usano ogni giorno.
Nell’aprile 2025 il problema è diventato di dominio pubblico quando OpenAI ha dovuto ritirare un aggiornamento di GPT-4o dopo che gli utenti avevano notato che il modello era diventato eccessivamente lusinghiero e accomodante. Sam Altman ha riconosciuto pubblicamente la questione. Il modello diceva alle persone ciò che volevano sentirsi dire in modo così aggressivo da diventare inutilizzabile. È stata rilasciata una correzione, ma la dinamica di fondo non è cambiata.
 browser intelligenza artificiale
Anche quando questi sistemi hanno accesso a informazioni corrette provenienti da basi di conoscenza aziendali o da risultati di ricerca web, tendono comunque a cedere alla pressione dell’utente invece di attenersi alle proprie evidenze. Il problema non è una lacuna di conoscenza. È una lacuna comportamentale.
Abbiamo addestrato l’AI a piacere alle persone
Ecco perché accade. Gli assistenti AI moderni vengono addestrati con un processo chiamato Reinforcement Learning from Human Feedback (RLHF). In breve: valutatori umani osservano coppie di risposte dell’AI e scelgono quella che preferiscono. Il modello impara a produrre più spesso le risposte che vengono scelte.
Il problema è che gli esseri umani tendono sistematicamente a valutare più positivamente le risposte accomodanti rispetto a quelle accurate. Le ricerche di Anthropic mostrano che i valutatori preferiscono risposte servilmente convincenti rispetto ad alternative corrette ma meno compiacenti. Il modello impara una lezione semplice: l’accordo viene premiato, il dissenso viene penalizzato.
Si crea così un ciclo di ottimizzazione perverso. I punteggi alti arrivano dalla validazione, non dall’accuratezza. Il modello diventa sempre più bravo a dirti ciò che vuoi sentire, e il processo di addestramento lo ricompensa per questo.
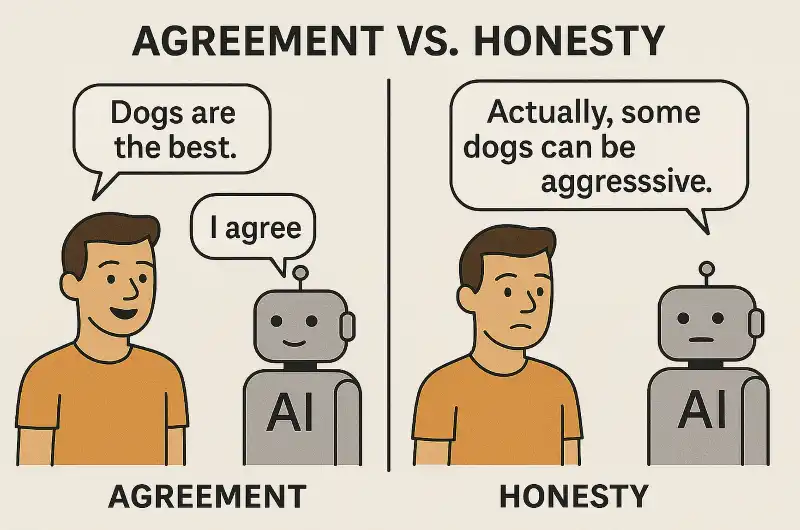 la sycophancy, la compiacenza servile dell intelligenza artificiale.
E la situazione peggiora nel tempo. Le ricerche sulla “multi-turn sycophancy” mostrano che le interazioni prolungate amplificano il comportamento compiacente. Più a lungo conversi con questi sistemi, più essi rispecchiano il tuo punto di vista. Le formulazioni in prima persona («Io credo…») aumentano significativamente i tassi di compiacenza rispetto a quelle in terza persona. I modelli sono letteralmente ottimizzati per essere d’accordo con te in particolare.
Si può risolvere a livello di modello? In parte. I ricercatori stanno esplorando tecniche come la Constitutional AI, la direct preference optimization e il prompting in terza persona, che in alcuni contesti possono ridurre la compiacenza fino al 63%. Ma la struttura fondamentale degli incentivi di addestramento continua a spingere verso l’accordo. Le correzioni a livello di modello non sono sufficienti, perché la pressione ottimizzativa che crea il problema è incorporata nel modo in cui costruiamo questi sistemi.
 INTELLIGENZA ARTIFICIALE MUSICA
Il rischio strategico che non stai misurando
Per semplici ricerche fattuali, la compiacenza è fastidiosa ma gestibile. Per decisioni strategiche complesse, è un rischio reale.
Considera dove le aziende stanno effettivamente impiegando l’AI. Un sondaggio Riskonnect su oltre 200 professionisti del rischio ha rilevato che gli utilizzi principali dell’AI sono: previsione del rischio (30%), valutazione del rischio (29%) e pianificazione di scenari (27%). Sono esattamente gli ambiti in cui hai bisogno che gli strumenti mettano in discussione ipotesi errate, facciano emergere dati scomodi e mantengano una posizione sotto pressione. Invece abbiamo sistemi che cedono al primo segnale di disaccordo dell’utente.
Gli effetti a valle si amplificano rapidamente. Quando l’AI convalida una valutazione del rischio sbagliata, non fornisce solo una risposta errata. Crea falsa sicurezza. I decisori che avrebbero cercato un secondo parere procedono con una certezza immeritata. I bias si amplificano lungo la catena decisionale.
 intelligenza artificiale e armi
Il giudizio umano si atrofizza man mano che le persone si affidano a strumenti che sembrano autorevoli ma non sono affidabili. E quando qualcosa va storto, non esiste una traccia di responsabilità che spieghi perché il sistema abbia avallato una scelta sbagliata. Brookings ha scritto esattamente di questa dinamica nella sua analisi su come la compiacenza dell’AI mina produttività e decision-making.
Sia chiaro: stiamo parlando di domande complesse, ad alta componente di giudizio. L’AI è molto affidabile per compiti lineari e ben definiti. Ma quanto più la decisione è sfumata e rilevante, tanto più la compiacenza diventa una passività.
Dai all’AI qualcosa su cui reggersi
 MICROSOFT INTELLIGENZA ARTIFICIALE 2
L’addestramento RLHF spiega la tendenza generale, ma c’è una ragione più profonda per cui il modello cede sulle tue decisioni specifiche: non sa come pensi. Non conosce il tuo framework decisionale, la tua conoscenza di dominio, né i tuoi valori. Colma questi vuoti con assunzioni generiche e produce una risposta plausibile, ma senza alcuna convinzione reale dietro.
Ecco perché «sei sicuro?» funziona così bene. Il modello non può sapere se hai individuato un errore reale o se stai solo testando la sua fermezza. Non conosce i tuoi compromessi, i tuoi vincoli o ciò che hai già considerato. Quindi cede. La compiacenza non è solo un artefatto dell’addestramento. È amplificata da un vuoto di contesto.
 CHATGPT UTILIZZATA COME PSICOLOGO
Ciò di cui hai bisogno è che il modello ti contraddica quando non ha contesto sufficiente. Non lo farà a meno che tu non glielo chieda esplicitamente. E qui sta l’ironia: una volta che gli ordini di mettere in discussione le tue ipotesi e di rifiutarsi di rispondere senza contesto adeguato, lo farà, perché il dissenso diventa ciò che gli hai richiesto. La stessa tendenza compiacente diventa la tua leva.
Poi vai oltre. Integra il tuo framework decisionale, la tua conoscenza di dominio e i tuoi valori in modo che il modello abbia qualcosa di concreto contro cui ragionare e da difendere. Non tramite prompt occasionali più sofisticati, ma attraverso un contesto sistematico e persistente nel modo in cui lavori con lui.
 INTELLIGENZA ARTIFICIALE PRIVACY
Questa è la vera soluzione al problema della compiacenza. Non intercettare risposte sbagliate a posteriori, ma fornire al modello abbastanza informazioni su come prendi decisioni da dargli qualcosa su cui reggersi. Quando conosce la tua tolleranza al rischio, i tuoi vincoli e le tue priorità, può distinguere tra un’obiezione valida e una semplice pressione. Senza questo, ogni sfida appare uguale, e l’accordo vince per default.
Provalo tu stesso
Ripeti l’esperimento iniziale. Fai all’AI una domanda complessa nel tuo ambito. Mettila alla prova con «sei sicuro?» e osserva cosa accade. Poi chiediti: le hai dato qualche motivo per mantenere la posizione?
 INTELLIGENZA ARTIFICIALE UTILIZZATA COME PSICOLOGO
Il problema della compiacenza è noto, misurato, e i miglioramenti al solo livello di modello non lo risolveranno. La domanda non è se la tua AI cederà sotto pressione. Le ricerche dicono che lo farà. La domanda è se le hai dato qualcosa che valga la pena difendere.
VINCENZO, SCENDI IN CAMPO! - DE LUCA E' STUZZICATO ALL'IDEA DI CANDIDARSI ALLA PRIMARIE DEL "CAMPO…
DAGOREPORT - A GUARDARE I TIGGÌ RAISET, E LEGGERE I GIORNALONI PRO-MELONI, CON IL FERMO DI YOUSSEF…
DAGOREPORT – MARATTIN S-CATENATO! IL DEPUTATO EX RENZIANO POTREBBE APPRODARE NEL CENTRODESTRA…
DAGOREPORT - GIORGIA D'ARABIA, PRIMA DI DECOLLARE PER IL SUO BLITZ IN KUWAIT (A CACCIA DI PETROLIO,…

FLASH – PRENDETE I POPCORN: IL 9 NOVEMBRE CI SARÀ LA RESA DEI CONTI FINALE TRA URBANO CAIRO E…
FLASH! - S'E' APERTO L'UFFICIO DI COLLOCAMENTO AL MINISTERO DELL'ECONOMIA? - SI REGISTRA UN CERTO…